MiniMax H3 硬件指南:显存、本地工作流与运行限制
核对 MiniMax H3 本地 Base 权重、ComfyUI 配置、量化和显存说法,区分本地生成与完整 2K 流程中的托管阶段。
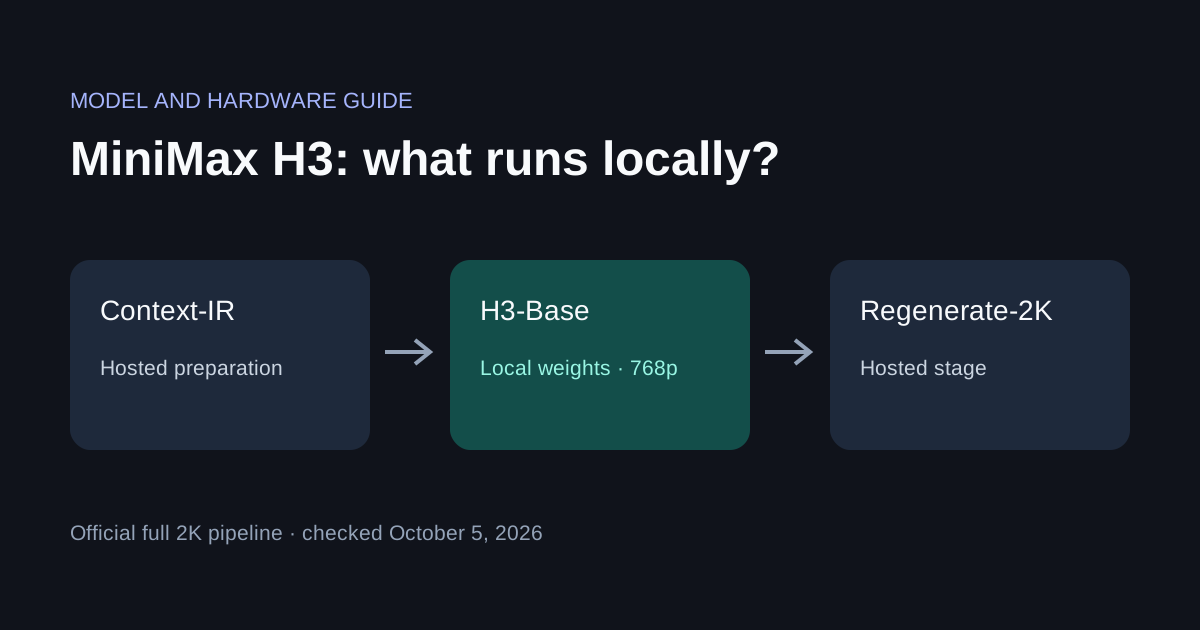
MiniMax H3 的 Base 模型有本地权重,官方完整 2K 流程还包含托管阶段。 “24 GB 能跑 H3”这样的说法,需要同时提供权重、精度、后端、分辨率与成功输出,才有选购参考价值。
本文核对日期为 2026 年 10 月 5 日,未进行 H3 硬件实测。Local AI Video 当前应用目录没有 H3,请使用下方官方工作流;应用现有视频路径见 LTX-2.5 本地指南。
哪部分可以本地运行?
MiniMax 官方仓库区分了三个组件:
| 组件 | 做什么 | 运行边界 |
|---|---|---|
| H3-Context-IR | 整理多模态指令 | 官方流程调用托管服务 |
| H3-Base | 生成 768p 视频与声音 | 已发布本地权重 |
| H3-Regenerate-2K | 将 Base 结果重新生成为 2K | 官方流程调用托管服务 |
Base 有面向文字、首尾帧的 FL2VA 和多模态参考的 Ref2VA。先选择任务再下载,避免把不用的模型和组件全部保存到硬盘。
本地打开 ComfyUI 不代表所有节点都离线。检查工作流有没有远程 API、上传素材、远程图片地址和云端后处理。如果任务必须断网,先把参考素材放在本地,并核对每个环节是否具备本地文件。
H3 到底需要多少显存?
没有一个数字能覆盖全部 H3 工作流。视频生成器、编码器、音频与视频解码器是否同时驻留,取决于后端;片长与参考输入还会增加中间计算占用。
官方 SGLang 示例使用 4 张 GPU,这是部署示例,不是“四卡是最低要求”的证明,也不能用它证明普通单卡可运行。官方部署说明。
| 现有硬件 | 决定投入前要核对什么 |
|---|---|
| 8–12 GB 显卡 | 精确量化、卸载设置及所需输出的完整成功记录,不能只看权重大小 |
| 16–24 GB 显卡 | 相同权重与任务下的显存峰值、系统内存和总耗时 |
| 大显存或多卡工作站 | 后端是否支持拆分,以及每张卡的峰值,不能只加总显存 |
| Apple Silicon Mac | 对应后端的实际兼容记录;统一内存大不代表支持 CUDA 流程 |
这些是核对标准,不是已经测出的兼容性等级。模型文件体积、硬盘空间、系统内存、独立显存应分开记录。看到“只需要 20 GB”,先确认指的是哪一种。
从 ComfyUI 原生模板开始
ComfyUI 官方 H3 教程提供原生模板与所需版本。先跑简单文生视频,再增加多模态参考或加速组件。
- 按模板要求更新 ComfyUI;核心节点缺失时先查启动日志。
- 从模板库选择 MiniMax H3 对应任务,按清单下载模型并保存文件名。
- 第一次保留模板搭配的模型、精度与采样设置,避免把陌生 LoRA 装到不同权重上。
- 用短片和一个简单动作开始,随输出保存工作流、种子和设置。
- 检查画面与音轨都完整后,再增加长度或尺寸。只有文件写出、不含完整声音的视频不算成功的音画测试。
可尝试的输入:“固定机位拍摄木桌上的红色陶瓷杯,蒸汽缓缓上升,安静室内环境声,无人声、无音乐。”这是建议测试输入,不是本文已生成的结果。
怎样记录一次完整测试
记录设备和驱动、后端版本、权重版本、精度、分辨率、帧数、参考素材数量与种子。可分别记录加载、采样、解码耗时,但也要保留端到端总耗时。第二次运行单独计时,以免把编译和缓存因素混在一起。
| 指标 | 作用 |
|---|---|
| 各卡显存峰值与系统内存 | 判断卸载是不是把瓶颈搬到了内存 |
| 实际尺寸、时长、音轨 | 确认目标任务真正完成 |
| 首次与重复耗时 | 区分初始化成本与正常运行 |
| 错误与最后完成阶段 | 区分加载、采样、解码不足 |
**本站 H3 测试状态:**尚无本地 GPU、Mac 或多卡数据。官方提供了可复现的 768p 输入与输出,可以作为对照,但不能当作 Local AI Video 的性能样例。
失败后先查什么?
- **缺节点:**先对应 ComfyUI 与工作流版本。
- **权重形状不匹配:**核对任务族、裁剪/量化版本与 LoRA。
- **解码时内存不足:**使用后端支持的降负载设置;模型加载成功不等于解码也能装下。
- **出现联网:**检查托管处理和远程素材输入,不要只看界面在本机运行。
- **加速后效果下降:**先以同一输入对照原模板,避免同时改动多个参数。
商业项目使用前阅读模型许可证。如果目标是使用应用现有视频功能,可先看 LTX-2.5 的 Mac 实测与 Windows 限制,更多模型见开放权重视频生成器比较。
更多文章

FramePack 是什么:原理、硬件要求和运行方法
FramePack 是 lllyasviel 开源的图生视频项目,号称 6 GB 显存就能跑 13B 视频模型。本文讲清它能做什么、FramePack GitHub 怎么装、需要什么硬件,以及许可证要注意什么。

LTX-2.5 本地运行指南:Mac、Windows、GGUF 与硬件实测
选择 LTX-2.5 Distilled 的 Mac MLX 或 Windows GGUF 路径,核对权重组件,查看 M5 Pro 历史视频实测与内存限制。

Wan 2.2 下载、GGUF 与本地部署,以及 Wan 2.5 开源了吗?
通义万相 Wan 2.2 去哪下载、Wan 2.2 GGUF 该选哪个文件、如何在本地用 ComfyUI 运行 Wan 2.2,以及 Wan 2.5 到底有没有开源。信息来自官方仓库。
邮件列表
加入我们的社区
订阅邮件列表,及时获取最新消息和更新